
データのAI レディを実現するソリューション
3つ目のステップが「整理・整形」だ。AIはPDFやExcelのデータをそのまま理解できるわけではない。ベクトル化やインデックス化といった処理を施し、AIが読み込める形に変換する必要がある。
ただし、不要なデータや不適切なデータが残っていると誤答の原因になる。かといって手作業による整理・整形は、概念実証(PoC)では成立しても、日々生成され増え続けるデータを相手に業務として継続するのは非現実的だ。この工程が、AIの本番稼働を阻む要因になりやすい。
「見える化、分類・文脈化、整理・整形というAIデータ準備のプロセスを自動化することが、データを本当の意味でAI レディにする条件です」と五十嵐氏は語る。そして、AIが読めるよう整えられた安全なデータを、学習、そして推論へと展開していく。Everpureは、社内に散らばる情報をすぐにAIで活用できる状態にするためのソリューションを提供しているという。
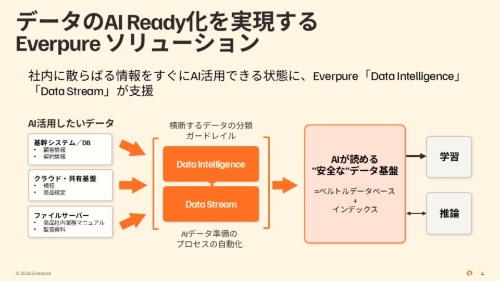
改めて全体を整理しよう。第一歩は、様々な場所やアプリケーションに分散したデータを見える化し、統一のプラットフォーム上で一元化することだ。次に、何がどこにあるのかが分かった段階で、中身や文脈、アクセス権限を把握する。重複はないか、古いデータが残っていないか、AIに処理させるための新しいデータを継続的に取り込めているか、といった点もあわせて確認する。
続いて、AIが読み込める形式へとデータを整理・整形する。手作業では本番化の妨げになるため、可能な限り自動化する。最後の学習・推論では、処理速度が遅ければビジネスの変化に追随できないため、必要に応じて高速化を図る。
「本番AIの成否を決めるのはデータ基盤です。AIモデルやGPUの性能で決まるわけではありません」。五十嵐氏はそう強調し、講演を締めくくった。